CATQ 分数解读:分数范围、临界分数,以及你能得出哪些结论
作者:Silas Rowland · 更新于 2026 年 11 月 3 日
一个 CATQ 分数描述的是你在社交伪装相关题目上的作答。它不能确定你是否自闭,不能解释每一次艰难的互动,也不能衡量你值得获得多少支持。这份问卷的总分可能落在 25–175 之间,但这个数学意义上的范围,和一条经过临床确立的分界线并不是一回事。最初的开发研究并没有为 CAT-Q 给出诊断临界分数。带着这个区分去读,查看 CAT-Q 问卷,把它当作一件反思工具。
解读任何一个数字之前,先检查三件事:问卷的计分方式、网站的实际显示方式,以及你想回答的问题是什么。任何你打算拿出来讨论的结果,都请把原始作答留在手边。
CAT-Q 的计分方式是怎样的
由 Hull 及其同事开发、发表于 2019 年的《自闭症特质伪装问卷》(CAT-Q)包含 25 道题目,每题有七个备选反应,选项从"非常不同意"排到"非常同意"。每题的计分范围是 1–7 分,其中指定的几道题在合并分数前会先做反向处理,共有五道题属于反向计分题目。对这些题来说,同意程度越高,分数并不会相应加得越高。如果你正在比较不同网站上的结果,或者想自己动手算出总分,这些细节就很关键。[1,2]
Hull 及其同事 2021 年的论文把可能的总分范围记为 25–175。[3] 一个接近任一端点的结果,描述的是你在这份问卷上的作答模式,并不会把你放到自闭症谱系的某个端点上。同样重要的是,要区分总分和题目平均分。一篇报告平均值的论文,如果不核对计分方法,就不能直接和显示总分的网站作比较。[3]
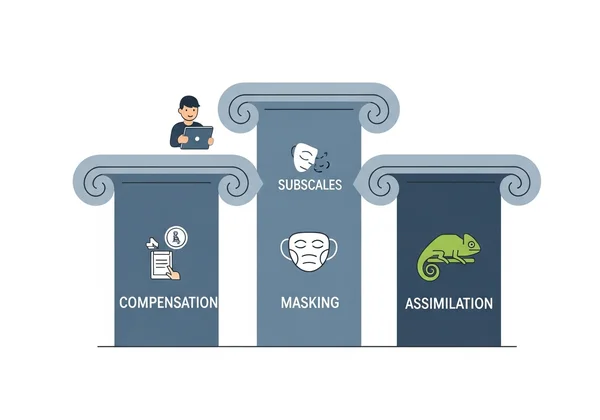
这份工具把题目分为补偿、伪装和同化三个分量表。补偿包含九道题,伪装和同化各包含八道题,所以它们的可能总分范围各不相同。如果把原始数字当作每个量表都有相同的满分来比,很容易被误导。我们专门写的 CAT-Q 分量表指南对这些差异有更详细的说明。[1]
| 分数或显示方式 | 它描述什么 | 它不能确立什么 |
|---|---|---|
| 总分 25–175 | 整份问卷合并计分后的作答 | 自闭症状态或临床严重程度类别 |
| 补偿,9–63 | 对补偿类题目的作答 | 某种策略在你的处境中是否真的有帮助 |
| 伪装,8–56 | 对伪装类题目的作答 | 痛苦的来源或合适的治疗方式 |
| 同化,8–56 | 对同化类题目的作答 | 你的身份、偏好,或你获得支持的资格 |
| 网站给出的百分比 | 该显示方式所做的换算 | 患自闭症的概率 |
这些范围是计分属性,不是诊断阈值。上面的分量表范围,直接来自开发论文中记载的题目数量和 7 点反应量表。[1]
本网站的结果页显示什么
本站的基础结果页会显示三个分量表的分数及其百分比:补偿满分 63 分,伪装满分 56 分,同化满分 56 分。它不显示总分,也不显示总分区间。任何关于总分分级的描述,都与这个基础结果页对不上。
如果你在别处保存过结果,先确认那到底是哪一份问卷、它的计分说明又是什么。CAT-Q 风格的测试可能会改动题干措辞、反应量表或题目取舍。它的数字不应自动被当作一份完整的 CAT-Q 结果来解读。这要看的是两者的测量方法是否可比,而不是谁的数字更大就更有意义。
在条件允许的情况下,保留原始的逐题作答,同时记下版本、日期,以及你当时心里想着的那个情境。如果某段解读和你的答案看起来对不上,先回去核对原始作答,再决定要不要接受那段说法。可选的 AI 解读只是基于你的作答生成的补充文字,它无法确定你这些体验的原因。
为什么临界分数无法回答"你是不是自闭"
最初的 CAT-Q 研究考察的是自评的伪装行为,样本中既有自闭症成年人,也有非自闭症成年人。这个研究背景至关重要:一份关于社交场合中所用策略的问卷,无法替代对一个人发展史、当下困难和整体处境的评估。非自闭症成年人同样会报告自己存在伪装行为。[1]
最初的开发论文并没有给出 CAT-Q 的诊断阈值。一个在网上被反复引用的数字,不会仅仅因为重复得多了,就自动获得临床上的权威性。更高的结果仍然是同一份问卷上的一个分数,而不是一个新的临床类别。得出那些结论所需要的信息,单靠总分是提供不了的。[1]
研究样本中的组别平均值,可以描述被研究样本内部的差异。它们不会变成一条适用于个人的"通过/不通过"规则。你也不需要先超过某个问卷边界,才可以把一段困难的经历带给合格的专业人士。反过来说,与许多伪装类题目都表示同意,也不能确立这份"同意"背后的解释。[1,2]
把分量表当作提问的起点,而不是性格类型
开发论文在其测量模型中区分了补偿策略、伪装策略和同化体验。这些构念提供了一套起手的词汇,但它们不会给你安上一个固定的人格标签,也不会判定你的动机。[1]
为了自我反思,你可以问自己:提前准备好一段对话,是否有助于你参与其中?隐藏自己的反应,是否感觉是必要的?加入一个群体,是否让你觉得出于自愿?另一个可能的例子是,把讨论引向事实,以避开一场难以预测的情绪交换。这只是一个示例情境,不是问卷题目,也不是能确立自闭症的迹象。
试着把观察和解释分开。"我排练了会议的开场"是观察;"这证明了我为什么会精疲力竭"是解释,而这种解释可能遗漏了其他方面的原因。一场有意义的讨论,可以保留那个观察,同时把解释悬而未决。
同一个回答,对不同的人也可能意味着不同的东西。与其断定你得分最高的那个分量表揭示了你的"真实风格",不如问自己:哪些题目示例与你的经历相符,哪些不符?补充哪些信息有助于厘清其中的差别?问卷无法替你结束那场讨论。
为什么研究中的相关性不会凭空造出一个个人临界分数
Hull 及其同事关于伪装、焦虑与抑郁的研究,在自闭症成年人群体中发现了若干自评测量之间的关联。作者明确指出:无法确定一个总体上具有临床意义的 CAT-Q 临界分数,因为这些效应因人而异、因情境而异。[3] 样本层面的关系,并不是某一个人的经历会突然切换类别的那个点。
这也有助于把"伪装分数"和"痛苦的原因"区分开来。较高的结果与焦虑可以同时出现,却无法说明哪一个在先、还有什么别的因素参与其中,以及改变某种策略是否有帮助。请把痛苦本身告诉专业人士,而不是把它翻译成基于分数的诊断。
Hannon 及其同事的综述比较了自评与其他测量伪装行为的方法,发现这些方法并不能简单地彼此替代。[2] 分数并不是社交能力的度量,也不是"你看起来的样子"与"你的感受"之间落差的度量。当这些体验与你的问题有关时,请把它们分开记录。
举一个具体的例子:摩根在两次会议前可能得到相似的问卷结果,却觉得其中一次还应付得来,另一次却让人筋疲力尽。会议形式、熟悉程度、要求强度或可获得的支持上的差异,都是值得追问的问题。结果本身无法指出究竟哪一个差异起了作用,所以请把这些细节和数字一起保留下来。
按问题选择测量工具,而不是按分数
NICE 的成人路径把 AQ-10 列为一项初步工具,与临床判断并列使用,而不是把 CAT-Q 当作自闭症的判定依据 [4]。一次全面的评估,既要包含发育情况,也要包含童年时期就存在的特质以及当下的体验。如果你关心的是自闭症,请询问那条评估路径,而不是去寻找一条能给评估画上句号的 CAT-Q 边界。
测量伪装也有不止一种方式。Hannon 及其同事比较了自评、家长报告,以及测量内外呈现差异的若干方法 [2]。他们的发现并不意味着这些分数可以互相替换。家长的观察、你对自己某种策略的描述,以及用两种测量算出的落差,是三个不同的信息来源。讨论一个结果时,请保留这些差异,而不是把它们平均成一个看似更确定的分数。
再加一份问卷有没有用,取决于它的用途是否契合你的问题。请记下工具的名称、版本、作答和相关的情境。去问合格的专业人士:哪些信息能帮你厘清那份困惑,还有哪些部分仍待评估。你完全可以就某一个具体困难去寻求支持,而不必收集足够多的网上分数来"确立"一个诊断。
一份真能用的"从结果到情境"工作表
用这份工作表把作答与具体例子联系起来,其中至少要有一个例子能让最初的解释变得复杂起来。不要在未经他人同意的情况下提交有关他们的信息。
| 情境 | 发生了什么(用可观察的方式描述)? | 我选择了做什么,或觉得必须做什么? | 还有什么不确定? | 一个问题或一项支持请求 |
|---|---|---|---|---|
| 工作或学习 | 记录一次具体的互动 | 描述一种策略,但不给它贴标签 | 其他要求、缺失的语境,或另一种可能的解释 | 索取议程、更清晰的说明,或一次讨论 |
| 朋友 | 记录一次自在的场合和一次困难的场合 | 记下哪些事感觉是可以不做的 | 差别来自同伴、场合,还是时机 | 商量一个更舒服的见面方式 |
| 家人 | 描述这次对话和其中的期待 | 记下你在哪里感到被施压 | 你还没向对方问出口的部分 | 提出更清晰的界限,或请求暂停一下 |
一个虚构的例子:摩根发现,为会议开场做准备感觉有用,而把每一种可能的回应都排练一遍则令人负担沉重。摩根把两者都记录下来,而不是把所有准备都视为问题。接下来要问的是:一份议程能否让参与变得更轻松。
请把这份工作表保持得足够简短,别让填写它本身变成另一项必须完美完成的任务。你可以留空某一格,用自己的话来写,也可以判断这份问卷对你没什么用。一个分数并不要求你接受某个标签,也不要求你在工作中透露个人信息。
参考文献
-
Hull L, Mandy W, Lai M-C, et al. Development and Validation of the Camouflaging Autistic Traits Questionnaire (CAT-Q). Journal of Autism and Developmental Disorders. 2019;49:819–833. doi: 10.1007/s10803-018-3792-6.
-
Hannon B, Mandy W, Hull L. A comparison of methods for measuring camouflaging in autism. Autism Research. 2023;16:12–29. doi: 10.1002/aur.2850.
-
Hull L, et al. 2021. Is social camouflaging associated with anxiety and depression in autistic adults? Molecular Autism. doi: 10.1186/s13229-021-00421-1.
-
National Institute for Health and Care Excellence. 2012, updated 2021. Autism spectrum disorder in adults: diagnosis and management. NICE CG142.
根据你的需要选择下一步
如果你主要是想理解这份问卷,先核对版本和计分方式。如果你想讨论那些影响日常生活的经历,就带着具体的例子去找合格的专业医疗人员。如果你的问题特别关乎自闭症评估,CAT-Q 的用途与局限指南会讲清楚"关于伪装的反思"与"更全面的评估"之间的区别。
不要因为某个分数或某段 AI 文字听起来很笃定,就去改变用药、选择治疗,或做出重大披露。你完全可以问:是什么证据支持这个解释?还有哪些可能性应当被纳入考虑?如果你觉得自己无法保证安全,或正处在伤害自己的即时风险中,请立刻联系当地紧急服务或危机支持热线;问卷结果不是紧急评估。
真正有用的终点,是一份更清晰的描述——你注意到了什么,你想获得什么样的帮助。不管结果高还是低,都不意味着你可以忽视自己的困难。让情境来引导下一次对话,而分数只是其中一块有限的信息。